


 向量模型
 Apache 2.0 授權
jina-embeddings-v2-base-en
Apache-2.0 Jina API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 實體隔離
 arXiv
概述
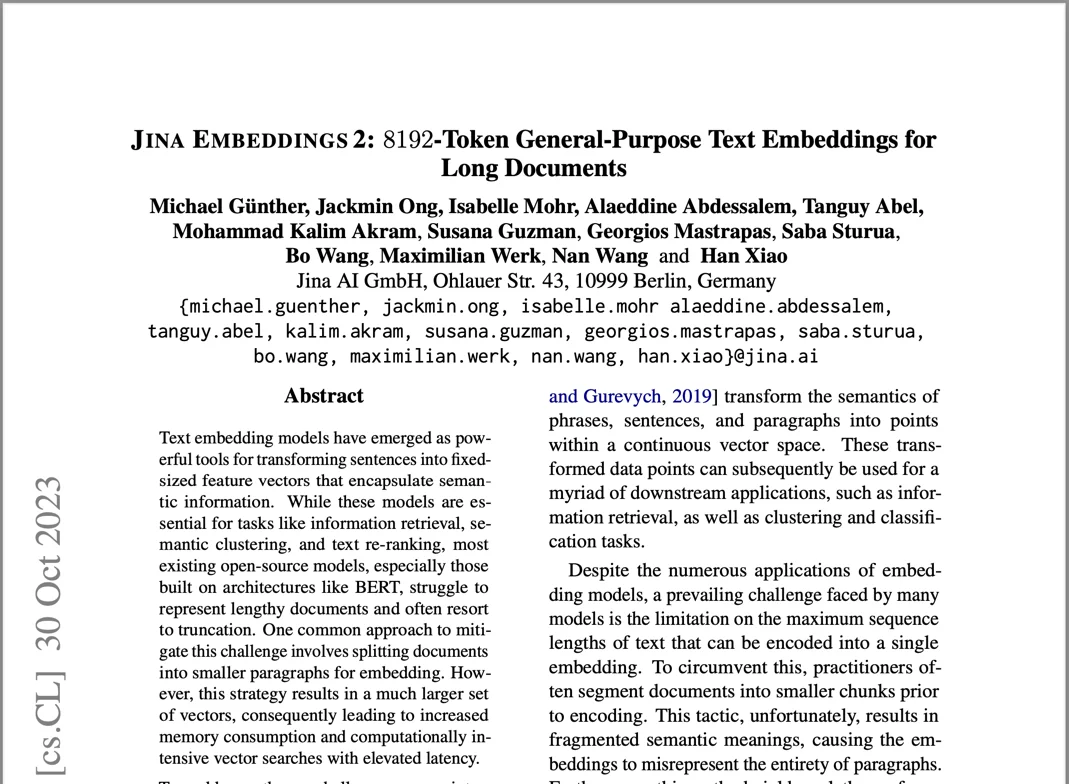
jina-embeddings-v2-base-en 是一個 137M 參數的英文文字向量模型,具備 8,192 詞元的上下文視窗,是當時標準 512 詞元上限的 16 倍。它建構在帶有對稱雙向 ALiBi(Attention with Linear Biases)的 BERT-small 骨幹上,是首個能原生處理長文件、無需截斷或分塊的開源 Jina 向量模型。它產生 768 維向量,在不需要 v3/v5 多語言或長上下文功能的純英文檢索中仍是可靠選項。
方法
該架構把 BERT-small Transformer(12 層、12 個注意力頭、768 隱藏維度)與對稱雙向 ALiBi 位置編碼搭配。ALiBi 以線性衰減的注意力偏誤取代學習式位置編碼,讓模型能遠遠超出 512 詞元的訓練長度、外推到 8,192 詞元而不犧牲效能。訓練採兩階段流程:先在 C4 上預訓練,再於 Jina 精選的 40 多個專用句對資料集上以困難負樣本挖掘微調。對稱雙向注意力確保每個詞元同時關注前文與後文,產生能捕捉句子整體語意的表示。對所有詞元表示取平均池化,得到最終的 768 維向量。
效能
發布時,該模型在多個 MTEB 英文子任務上勝過 OpenAI 的 text-embedding-ada-002:分類(73.45% 對 70.93%)、重排序(85.38% 對 84.89%)、檢索(56.98% 對 56.32%)、摘要(31.6% 對 30.8%)。8,192 詞元的上下文相對於當時僅支援 512–2,048 詞元的競爭模型是一大優勢,可做文件級檢索而不必分塊。精簡的 307MB 佔用讓它能在消費級 GPU 上部署。2026 年,jina-embeddings-v5-text-small(677M 參數、32K 上下文、任務特定 LoRA 適配器)在大多數生產工作負載上表現更好,但它在輕量純英文管線中仍有其位置。
最佳實務
當 8K 上下文視窗就夠用、也不需要多語言或任務特定適配器時,純英文檢索就用這個模型。文件超過 8,192 詞元時,請先做語意分塊再向量化。該模型可與主流向量資料庫(Qdrant、Weaviate、MongoDB Atlas、Milvus)及 RAG 框架(LangChain、LlamaIndex、Haystack)整合。新專案若需要多語言支援、32K 上下文或任務特定最佳化,建議改用 jina-embeddings-v5-text-small。生產吞吐量建議搭配支援 CUDA 的 GPU;CPU 推理可行,但會慢上不少。


