

 向量模型
 Apache 2.0 許可證
jina-embeddings-v2-base-es
Apache-2.0 Jina API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 物理隔離
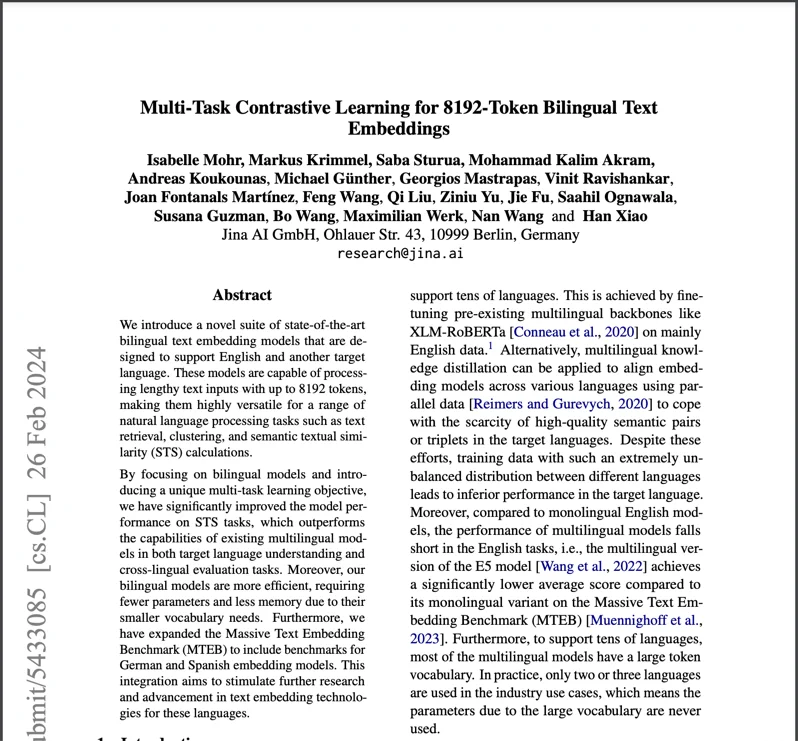
 arXiv
概述
jina-embeddings-v2-base-es 是一個 161M 參數的西英雙語文字向量模型,具有 8,192 token 的上下文視窗和 768 維輸出。它為西班牙語市場的跨語言檢索而設計,將語意等價的西語英語內容映射到共享的向量空間。該模型解決了一個關鍵缺口:當時大多數向量模型以英語為中心,西語性能顯著下降。
方法
該模型使用帶有對稱雙向 ALiBi 位置編碼的 BERT 骨幹、161M 參數和 768 維輸出空間。訓練遵循三階段流程:(1) 西英平行語料庫上的預訓練,(2) 精選句對上的含困難負樣本挖掘的對比微調,(3) 確保同一概念的西語英語表示聚集在一起的跨語言對齊。ALiBi 機制在不使用學習位置編碼的情況下實現了 8,192 token 的上下文,使模型能外推超過其 512 token 訓練長度。平均池化產生最終的向量。
效能
該模型在西班牙英語檢索任務上顯著超過更大的多語言模型(E5、BGE-M3),而僅為其大小的 15–30%。它在 MTEB 西語子任務上表現出色,尤其在檢索和聚類方面。8,192 token 的上下文視窗在多頁文件上提供了穩定的性能,而大多數競爭模型需要分塊。2026 年,jina-embeddings-v5-text-small 取代該模型,提供 89 種語言、32K 上下文和任務特定 LoRA 適配器。v2-base-es 模型仍是專用西英流水線的經濟實惠選擇。
最佳實踐
非常適合西英雙語搜尋、內容推薦和跨語言文件分析。對於超過 8,192 token 的文件,使用語意分塊或透過 Jina API 的 `late_chunking 參數。該模型可與主要向量資料庫和 RAG 框架整合。對於需要西英之外多語言覆蓋、32K 上下文或任務特定最佳化的新專案,請優先使用 jina-embeddings-v5-text-small`。生產環境建議使用支援 CUDA 的 GPU。輸入文字應為西班牙語或英語;支援混合語言輸入,但性能針對兩種訓練語言最佳化。


