


Comme beaucoup de gens, j'écoute de nombreux podcasts. Certains parlent de science-fiction. D'autres de paléontologie. Et d'autres encore de types bizarres du Moyen Âge. Pas de true crime malheureusement, à part mon goût parfois douteux.
Mais... c'est fastidieux d'écouter tous ces podcasts. Et ce n'est pas le pire. Je suis aussi abonné à beaucoup de flux d'actualités. Et cela peut faire beaucoup de lecture. Ce serait fantastique si je pouvais simplement prendre tout le contenu de ces flux d'actualités, le résumer en cinq minutes et faire en sorte que mon téléphone me le lise pendant que je me brosse les dents le matin.
Vous devinez probablement où je veux en venir. J'utilise Python pour créer un outil avec (principalement) la stack technologique de Jina pour créer mon podcast quotidien personnalisé d'actualités.
Si vous voulez passer directement à l'écoute, vous pouvez l'entendre ci-dessous :
tagQu'est-ce qu'un flux d'actualités ?
Tout d'abord, je les appelle « flux d'actualités » car la plupart des gens ne sont pas familiers avec les termes RSS ou Atom feeds. En bref, un flux est une liste structurée d'articles publiés par un blog ou une source d'actualités, classés du plus récent au plus ancien. De nombreux sites les proposent, et il existe plusieurs applications et sites web qui vous permettent d'importer tous vos flux, vous permettant de lire toutes vos actualités dans une seule application, sans avoir à visiter les sites web d'Ars Technica, des sites de fans de Taylor Swift, et du Washington Post :
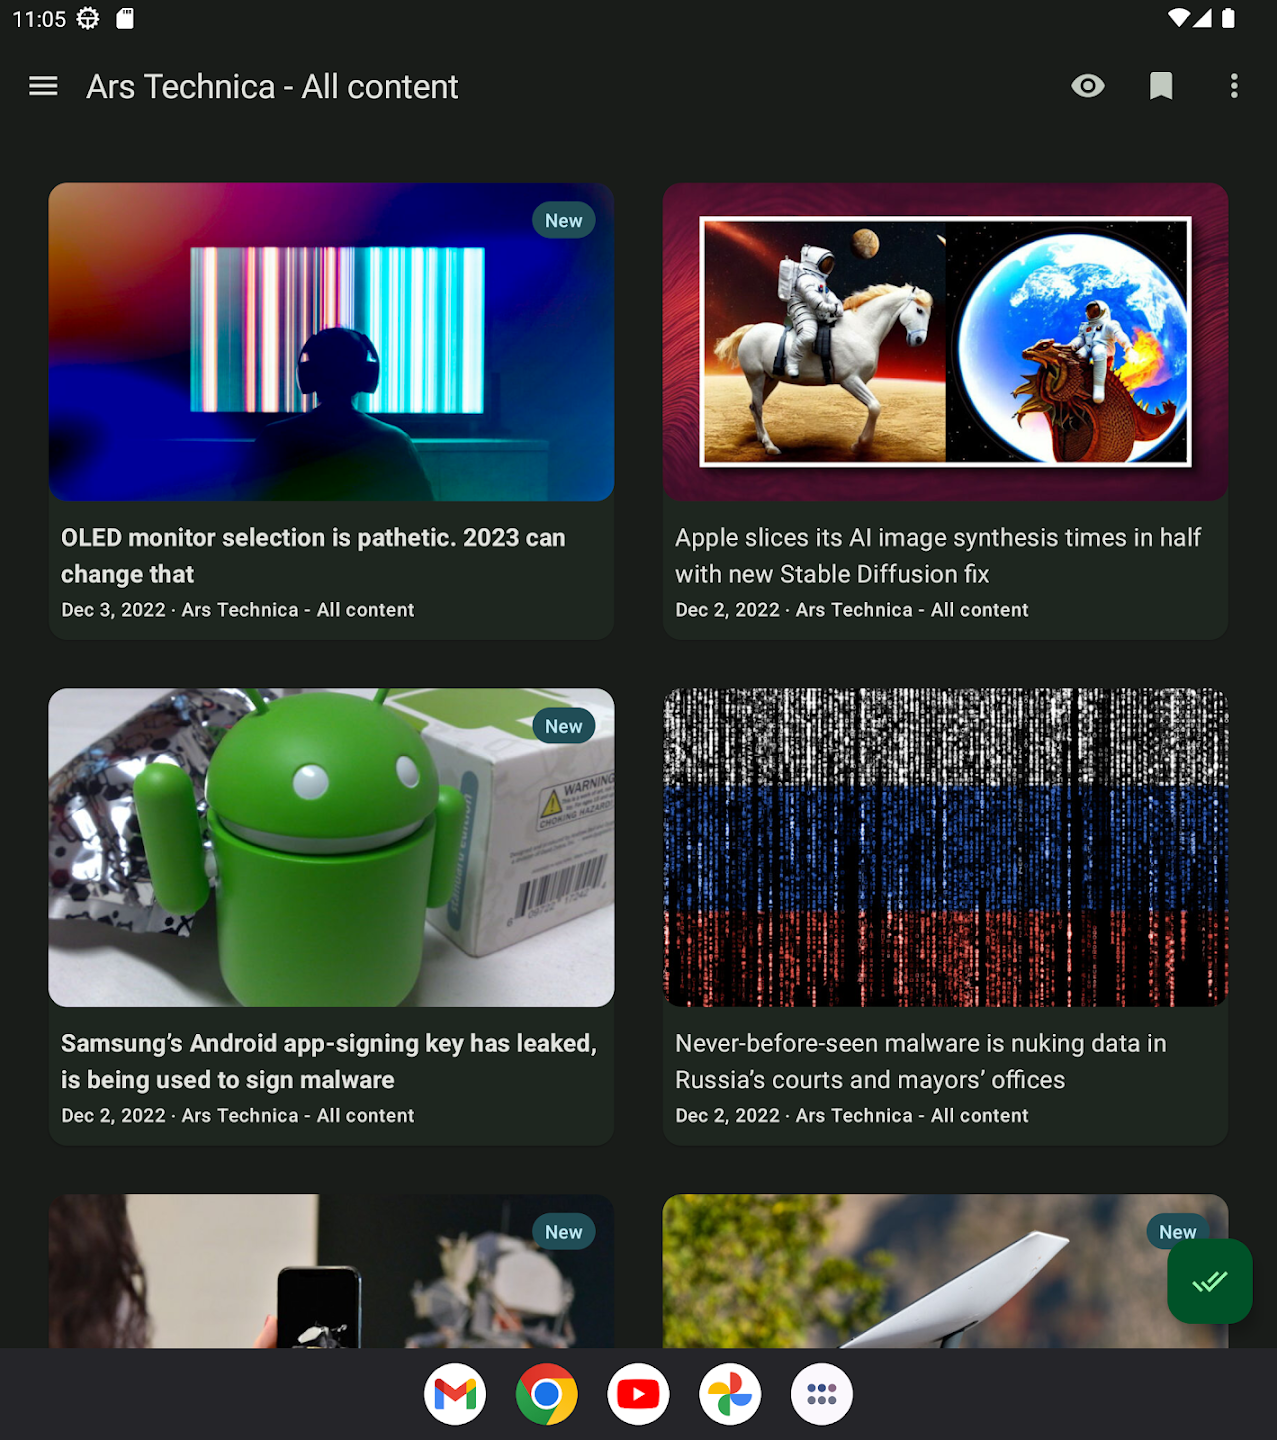
C'est une technologie ancienne du web préhistorique, mais de nombreux sites web la prennent en charge, y compris le blog de Jina AI (voici notre flux).
En bref, les flux vous permettent de lire toutes vos actualités en un seul endroit, en évitant tous les éléments parasites et les publicités. Dans cet article, nous utiliserons les flux d'actualités pour trouver et télécharger les derniers articles des sites que nous suivons.
tagLançons cette frénésie d'alimentation
pip install et les clés de configuration se trouvent dans ce post. Si vous souhaitez suivre, consultez le notebook pour l'expérience complète et gardez ce post pour avoir une vue d'ensemble.Lien Colab | Lien GitHub
Pour réaliser cette magie, nous allons utiliser plusieurs services et bibliothèques Python :
- Feedparser : Une bibliothèque Python pour télécharger et extraire le contenu des flux d'actualités.
- Jina Reader : L'API de Jina pour extraire uniquement le contenu de chaque article, sans télécharger les éléments superflus comme les en-têtes, pieds de page et barres latérales.
- PromptPerfect : Prompts-as-Services résumera chaque article puis combinera ces résumés en un seul paragraphe, dans le style d'un présentateur de NPR.
- gTTS : La bibliothèque Text-to-Speech de Google, pour lire les actualités à voix haute.
C'est tout ce que nous couvrirons dans ce post. Si vous souhaitez créer un flux podcast pour votre podcast personnalisé, nous vous suggérons de consulter d'autres sources.
tagTéléchargement des Flux
Comme il s'agit d'un exemple simple, nous nous contenterons de quelques flux d'actualités de The Register et OSNews, deux sites d'actualités tech.
feed_urls = [
"https://www.osnews.com/feed/",
"https://www.theregister.com/headlines.atom"
]Avec Feedparser, nous pouvons télécharger les flux puis extraire les liens des articles de chaque flux :
import feedparser
for feed_url in feed_urls:
feed = feedparser.parse(feed_url)
for entry in feed["entries"]:
page_urls.append(entry["link"])tagExtraction du Texte des Articles avec Jina Reader
Chaque flux contient des liens vers chaque article sur le site web correspondant. Si nous téléchargeons simplement cette page web, nous obtenons beaucoup de HTML, y compris les barres latérales, en-têtes, pieds de page et autres éléments superflus dont nous n'avons pas besoin. Si vous donnez cela à un LLM, c'est comme si vous mâchiez de l'herbe. Certes, le LLM peut le faire, mais ce n'est pas ce qu'il veut naturellement consommer.
Ce qu'un LLM veut vraiment, c'est quelque chose proche du texte brut. Jina Reader convertit un article en Markdown.
Cela le fait ressembler à ceci :
Title: Unintended acceleration leads to recall of every Cybertruck produced so far
URL Source: https://www.theregister.com/2024/04/19/tesla_recalls_all_3878_cybertrucks/?td=rt-3a
Published Time: 2024-04-19T13:55:08Z
Markdown Content:
Tesla has issued a recall notice for every single Cybertruck it has produced thus far, a sum of 3,878 vehicles.
Today's [recall notice](https://static.nhtsa.gov/odi/rcl/2024/RCLRPT-24V276-7026.PDF) \[PDF\] by the National Highway Traffic Safety Administration states that Cybertrucks have a defect on the accelerator pedal, which can get wedged against the interior of the car, keeping it pushed down. The pedal actually comes in two parts: the pedal itself and then a longer piece on top of it. That top piece can become partially detached and then slide off against the interior trim, making it impossible for the pedal to lift up. This defect [was already suspected](https://www.theregister.com/2024/04/15/tesla_lays_off_10_percent/) as Tesla paused production of the Cybertruck due to an "unexpected delay." Some Cybertruck owners also spoke on social media about their vehicles uncontrollably accelerating, with one crashing into a pole and another demonstrating [on film](https://www.tiktok.com/@el.chepito1985/video/7357758176504089898) how exactly the pedal breaks and gets stuck.
...Nous avons raccourci ceci car inclure l'article entier serait excessif. Mais vous pouvez voir que c'est un texte clair et lisible (markdown).
Au lieu de ceci :
<!doctype html>
<html lang="en">
<head>
<meta content="text/html; charset=utf-8" http-equiv="Content-Type">
<title>Unintended acceleration leads to recall of every Cybertruck • The Register</title>
<meta name="robots" content="max-snippet:-1, max-image-preview:standard, max-video-preview:0">
<meta name="viewport" content="initial-scale=1.0, width=device-width"/>
<meta property="og:image" content="https://regmedia.co.uk/2019/11/22/cybertruck.jpg"/>
<meta property="og:type" content="article" />
<meta property="og:url" content="https://www.theregister.com/2024/04/19/tesla_recalls_all_3878_cybertrucks/" />
<meta property="og:title" content="Unintended acceleration leads to recall of every Cybertruck" />
<meta property="og:description" content="That isn't what Tesla meant by Full Self-Driving" />
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:site" content="@TheRegister">
<script type="application/ld+json">
...Nous avons dû couper court avant même d'arriver au contenu réel. Il y a tellement d'éléments illisibles pour l'humain.
En donnant au LLM quelque chose qu'il peut digérer plus naturellement (comme du markdown plutôt que du HTML), il peut nous donner de meilleurs résultats. Sinon, c'est comme donner des Doritos à un lion. Certes, il peut les manger, mais il ne sera pas son meilleur lui-même lion s'il maintient ce régime.
Pour extraire uniquement le texte de manière lisible, nous utiliserons l'API de Jina Reader :
import requests
articles = []
for url in page_urls:
reader_url = f"https://r.jina.ai/{url}"
article = requests.get(reader_url)
articles.append(article.text)https://r.jina.ai/<url>, par exemple https://r.jina.ai/https://www.theregister.com/2024/04/19/wing_commander_windows_95/tagRésumer les articles avec PromptPerfect
Comme il peut y avoir beaucoup d'articles, nous utiliserons un LLM pour résumer chacun séparément. Si nous les rassemblons tous et les donnons au LLM pour les résumer, il pourrait s'étouffer avec trop de tokens à la fois.
Cela variera en fonction du nombre d'articles que vous souhaitez traiter. Pour quelques-uns seulement, il peut être utile de les concaténer tous en une longue chaîne et de faire un seul appel, gagnant ainsi du temps et de l'argent. Cependant, pour cet exemple, nous supposerons que nous traitons un plus grand nombre d'articles.
Pour les résumer, nous utiliserons un Prompt-as-a-Service de PromptPerfect.
PromptPerfect
Voici notre Prompt-as-Service :

Nous allons écrire une fonction pour cela, car nous appellerons un autre Prompt-as-Service plus tard dans cet article :
def get_paas_response(id, template_dict):
url = f"https://api.promptperfect.jina.ai/{id}"
headers = {
"x-api-key": f"token {PROMPTPERFECT_KEY}",
"Content-Type": "application/json"
}
response = requests.post(url, headers=headers, json={"parameters": template_dict})
if response.status_code == 200:
text = response.json()["data"]
return text
else:
return response.textNous allons ensuite prendre chaque résumé et les ajouter à une liste, pour finalement les concaténer en une liste markdown à puces :
summaries = []
for article in articles:
summary = get_paas_response(
prompt_id="mkuMXLdx1kMU0Xa8l19A",
template_prompt={"article": article}
)
summaries.append(summary)
concat_summaries = "\n- ".join(summaries)tagGénérer un rapport d'actualités avec PromptPerfect
Maintenant que nous avons cette liste à puces, nous pouvons l'envoyer à un autre Prompt-as-a-Service pour générer un bulletin d'information qui sonne comme un discours naturel de présentateur :

Le prompt complet est :
Vous êtes un rédacteur en chef des actualités technologiques de NPR. Vous avez reçu les résumés d'actualités suivants :
[summaries]
Votre tâche est de donner un aperçu en un paragraphe des actualités, couvrant chaque élément de manière organique, avec des transitions vers l'élément suivant. Vous pouvez modifier l'ordre des éléments si cela a du sens, et fusionner les doublons.
Vous produirez un script d'un paragraphe qui sonne naturel, à lire sur les actualités quotidiennes de NPR. Le script ne devrait pas prendre plus de cinq minutes à lire à voix haute.
Nous obtiendrons le script d'actualités avec ce code :
news_script = get_paas_response(
prompt_id="tmW07mipzJ14HgAjOcfD",
template_prompt={"summaries": concat_summaries}
)Voici le texte final :
Dans l'actualité technologique d'aujourd'hui, nous avons une série de mises à jour et de développements à aborder. Tout d'abord, l'outil Tiny11 Builder offre aux utilisateurs la possibilité d'alléger Windows 11 en créant une image personnalisée adaptée à leurs préférences. Passant au monde du jeu vidéo, nous explorons les composants cachés à l'intérieur des cartouches Super Nintendo, mettant en lumière la technologie qui fascinait les joueurs dans les années 90. Changeant de registre pour parler des logiciels, le gestionnaire de fenêtres en mosaïque Niri pour Wayland a publié une mise à jour majeure, offrant de nouvelles fonctionnalités comme le défilement infini et des animations améliorées. Dans le domaine de l'IA, la fonctionnalité Copilot de Microsoft a rencontré quelques difficultés lors de son déploiement auprès des Windows Insiders, avec des bugs et un comportement intrusif qui ont conduit à l'arrêt du déploiement. Pendant ce temps, le Bureau du Commissaire à l'Information du Royaume-Uni soulève des inquiétudes concernant le Privacy Sandbox de Google, questionnant ses implications en matière de confidentialité et son impact sur la concurrence. Enfin, l'Administration Fédérale de l'Aviation des États-Unis a mis à jour ses exigences en matière de licence de lancement, exigeant désormais que les véhicules de rentrée obtiennent une licence avant le lancement, suite à un incident impliquant Varda Space Industries. Ces diverses histoires technologiques mettent en évidence les progrès et les défis continus dans le monde de la technologie.
tagLire les actualités à voix haute
Pour lire le texte à voix haute, nous utiliserons la bibliothèque TTS de Google.

from gtts import gTTS
tts = gTTS(news_script, tld="us")
tts.save("output.mp3")Cela nous donnera un fichier audio final :
tagProchaines étapes
Nous n'allons pas couvrir le reste de l'expérience de création de podcast dans cet article. Ce n'est pas notre domaine d'expertise, et tout comme pour les conseils médicaux, vous ne devriez probablement pas nous écouter concernant les détails techniques de la configuration d'un flux podcast, de sa mise en ligne sur Spotify, Apple Podcasts, etc. Pour des conseils médicaux ou sur les podcasts, consultez respectivement votre médecin ou Joe Rogan.
Quant aux autres possibilités de Jina Reader, pensez à toutes les applications RAG que vous pouvez créer en téléchargeant des versions lisibles de n'importe quelle page web. Ou pour PromptPerfect, découvrez comment il peut aider davantage les YouTubers (ou les marketers, si c'est votre truc.)


